2026-09-14
Construyendo un pipeline de analítica serverless en AWS (y todo lo que se rompió por el camino)
Construyendo un pipeline de analítica serverless en AWS (y todo lo que se rompió por el camino)
Me gusta pinchar música electrónica como hobby y subo mis sesiones a SoundCloud. Lo que no tenía era una forma real de ver cómo funcionan con el tiempo: cómo evolucionan las reproducciones, si una pista empieza a ganar tracción semanas después de publicarla o cuándo podría tener sentido subir algo nuevo. Así que monté un pequeño pipeline que recoge mis propias estadísticas de SoundCloud cada día, las guarda y las muestra en un dashboard que realmente consulto.
La otra razón por la que existe este proyecto es que quería aplicar Infrastructure as Code y una arquitectura serverless de AWS a un problema real que me interesara, en vez de hacer otro ejercicio siguiendo un tutorial. En este post explico la arquitectura, las decisiones que hay detrás y, sobre todo, las cosas que solo se rompieron cuando desplegué contra una cuenta real de AWS y no mientras estaba leyendo la documentación.
Arquitectura
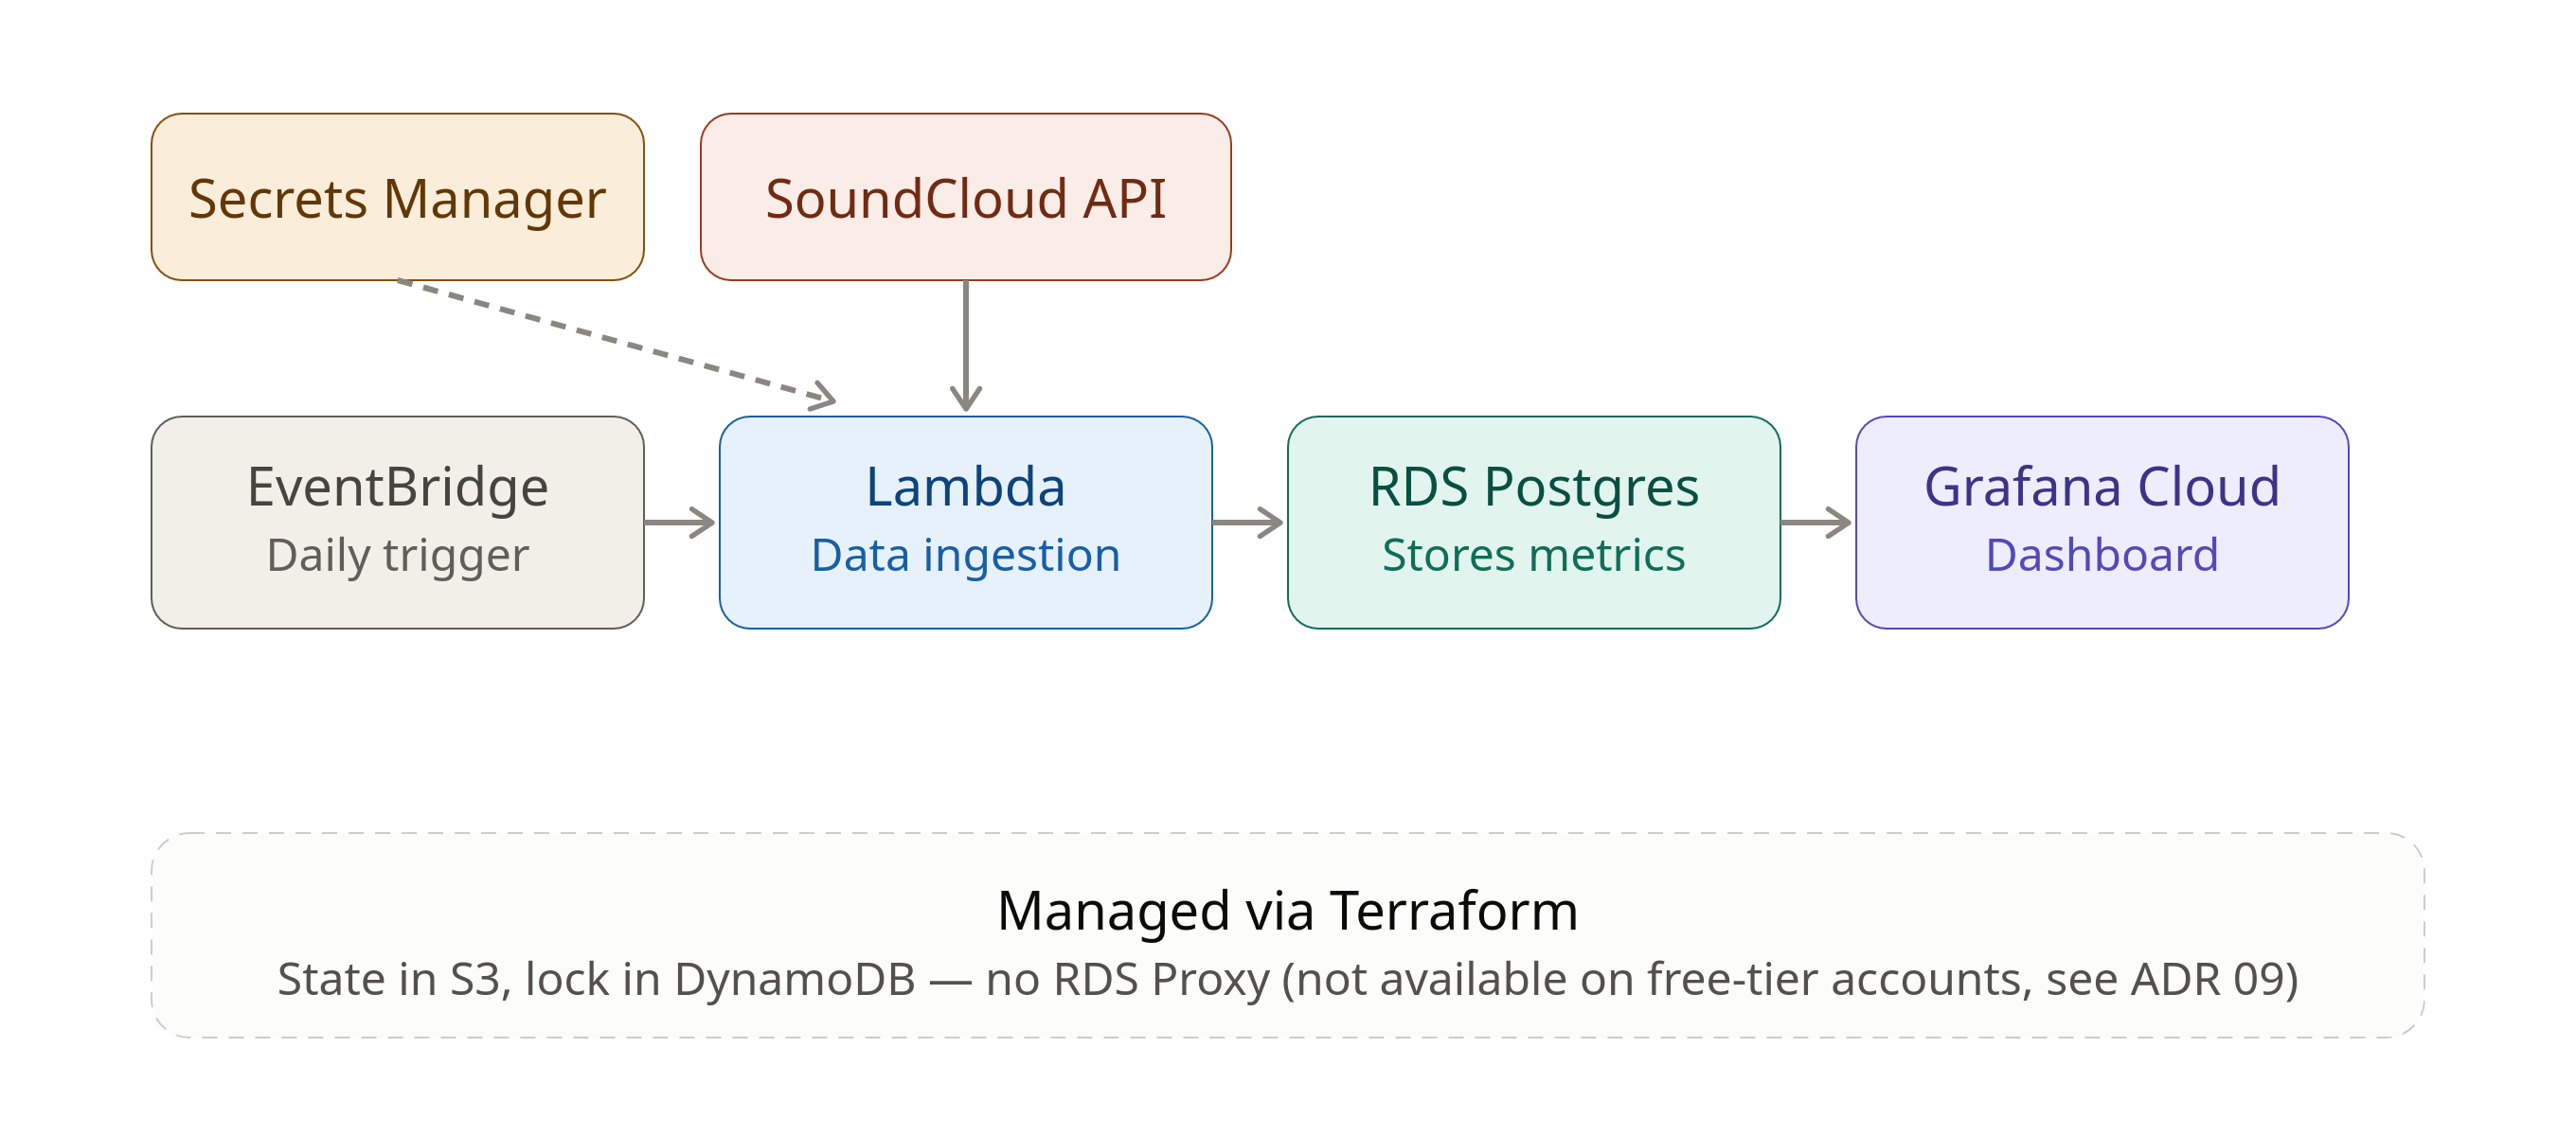
El pipeline es completamente serverless:
- EventBridge ejecuta una función Lambda una vez al día (
rate(1 day)). - Lambda se autentica contra la API de SoundCloud mediante OAuth2 y el flujo de refresh token, obtiene las estadísticas de las pistas y de la cuenta, y las guarda en RDS Postgres.
- Las credenciales de SoundCloud están en Parameter Store; la contraseña maestra de RDS se genera automáticamente y se guarda en Secrets Manager. Lambda nunca trabaja con ninguna de las dos en texto plano.
- Grafana Cloud lee los datos de RDS mediante un usuario PostgreSQL dedicado con permisos de solo lectura y muestra el dashboard.
- Todo se aprovisiona con Terraform, usando S3 para el estado remoto y DynamoDB para el locking.
El proyecto está pensado para ejecutarse bajo demanda, no 24/7: hago terraform apply, dejo que recoja datos durante unos días, saco las capturas y después lo destruyo. Para un proyecto de portfolio sin tráfico real, esto mantiene el coste prácticamente a cero sin renunciar a las lecciones de arquitectura.
Decisiones que merece la pena explicar
Postgres en lugar de DynamoDB
Los datos son inherentemente relacionales: pistas con sus snapshots diarios y un snapshot de la cuenta por día. Elegí RDS Postgres en lugar de DynamoDB precisamente porque me obligaba a enfrentarme a un problema conocido de las arquitecturas serverless: gestionar las conexiones a una base de datos desde una función que se crea y desaparece constantemente. DynamoDB habría evitado ese problema por completo, que es precisamente una de las razones por las que no lo elegí.
RDS Proxy: lo añadí y después tuve que quitarlo tras un fallo en un despliegue real
Esta es probablemente la decisión de la que más aprendí. Al principio añadí RDS Proxy para gestionar el connection pooling, sobre todo porque tenía valor como parte demostrativa del proyecto. El workload real es una ejecución de Lambda al día, así que no lo necesitaba ni de lejos. La arquitectura inicial era esta:
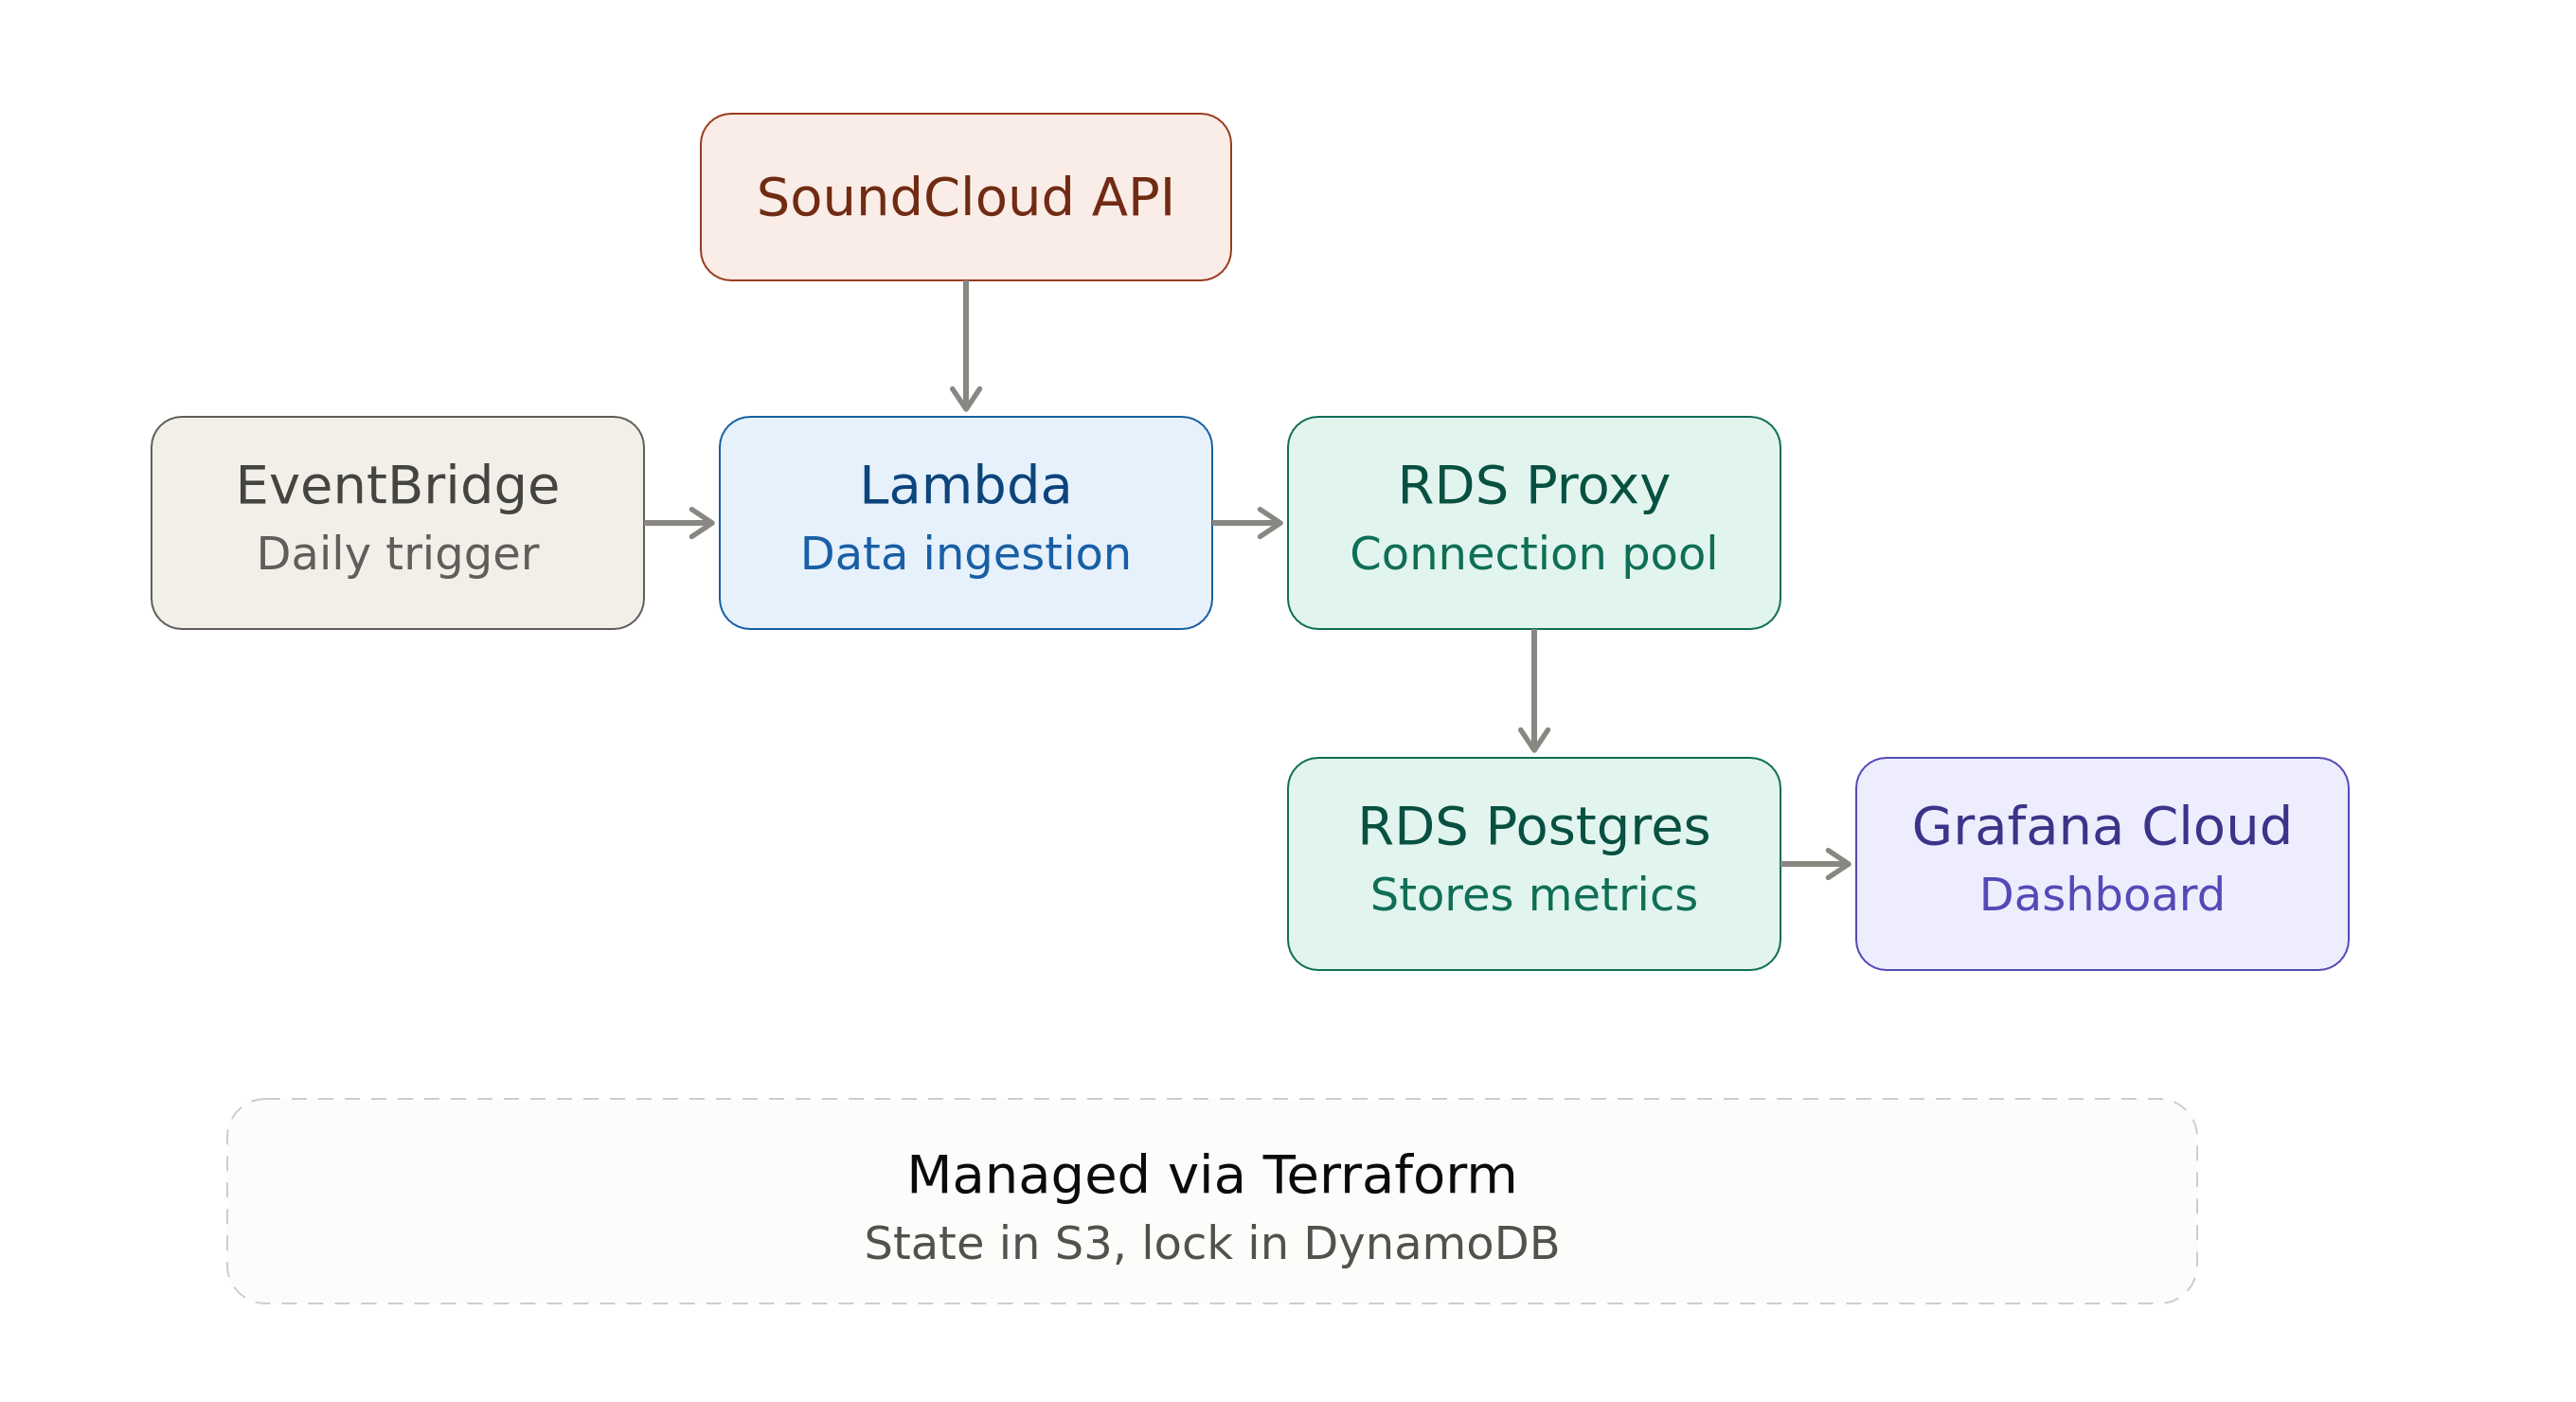
terraform plan y terraform validate pasaban correctamente. Después ejecuté terraform apply y falló:
FreeTierRestrictionError: This feature isn't available with free plan accounts.
RDS Proxy simplemente no está disponible en una cuenta de AWS con free tier, y esto no se puede saber con plan o validate: esos comandos comprueban la sintaxis y la consistencia interna, pero no las condiciones concretas de la cuenta. Eliminé el Proxy y Lambda pasó a leer directamente la contraseña de la base de datos desde Secrets Manager.
Creo que esta historia es más interesante que simplemente decir "usé RDS Proxy". Es un ejemplo pequeño y real de algo que aparece constantemente en trabajo de infraestructura: una decisión puede parecer correcta sobre el papel hasta que se encuentra con las limitaciones reales del entorno donde tiene que ejecutarse.
Abrir RDS a Internet, de forma consciente
RDS tiene un endpoint público protegido mediante Security Group. No hay una VPC privada ni un NAT Gateway. Un NAT Gateway tiene un coste mensual real simplemente por existir, y no tenía mucho sentido para un proyecto que se despliega bajo demanda y tiene tan poco tráfico. El trade-off es explícito: la seguridad de RDS depende aquí completamente de las credenciales y no del aislamiento de red. Es un compromiso aceptable para un proyecto de portfolio sin datos reales de usuarios, pero no sería una opción para producción con información sensible.
Esta decisión tuvo además una segunda parte que no esperaba: una vez desplegada Lambda, la primera ejecución real falló por timeout de conexión porque las funciones Lambda fuera de una VPC personalizada no tienen una IP fija y predecible. Mi Security Group solo permitía mi propia IP. Al final abrí el acceso al puerto de PostgreSQL desde cualquier IP, en lugar de añadir un NAT Gateway o montar una configuración con Elastic IP solo para darle una dirección estable a Lambda.
Lo que realmente se rompió (y cómo lo encontré)
terraform plan decía que todo estaba bien. No lo estaba.
La función Lambda tiene un argumento layers que conecta el paquete con las dependencias (requests, psycopg2-binary, etc.). Construí el Layer, escribí la función y ejecuté plan: todo limpio. Hice apply: sin errores. Primera ejecución:
Unable to import module 'script': No module named 'requests'
Pasé un rato revisando el contenido del ZIP del Layer y su historial de versiones en AWS. Todo estaba bien. El problema real era mucho más simple: simplemente nunca había añadido la línea layers = [...] dentro de aws_lambda_function. Una lista de layers vacía es una configuración válida para Terraform. No hay nada que parezca incorrecto para plan, porque una Lambda sin layers es perfectamente válida, solo que no era lo que yo quería.
aws lambda get-function-configuration --function-name ingestion_lambda_function --query "Layers"
Devolvió null, y eso fue lo que finalmente me llevó al problema real.
Una versión de Postgres que ya no existía
terraform apply sobre la instancia de RDS falló con:
InvalidParameterCombination: Cannot find version 16.4 for postgres
Había elegido esa versión de memoria. La lista de versiones soportadas por RDS cambia con el tiempo, y una de las cosas que plan y validate no pueden decirte es si un valor concreto sigue siendo válido para el servicio real. Ahora comprobar la lista actual antes de fijar una versión es simplemente parte de mi workflow:
aws rds describe-db-engine-versions --engine postgres --region eu-west-1 \
  --query "DBEngineVersions[].EngineVersion" --output table
El signo de exclamación que rompió bash
Los ARN de Secrets Manager para las contraseñas generadas automáticamente por RDS tienen un formato parecido a rds!db-6cc4fd1e-.... Ese ! dentro de una cadena de bash entre comillas dobles se interpreta como history expansion, haciendo que el comando falle con event not found. Las comillas simples lo solucionaron. Es una tontería, pero es el tipo de detalle que te puede hacer perder diez minutos la primera vez que aparece.
Grafana usando por defecto el formato de consulta equivocado
El primer panel que hice en la vista Explore de Grafana mostraba Data outside time range y representaba track_id como si fuera un valor numérico en vez de como una etiqueta de serie. El editor de consultas usa Table por defecto, no Time series. Con el formato Table, Grafana no sabe qué columna debe usar como eje temporal. Cambiar a Time series, poner explícitamente la columna de fecha como AS time y convertir track_id a text para que se trate como etiqueta en lugar de valor solucionó el problema inmediatamente.
Funciona
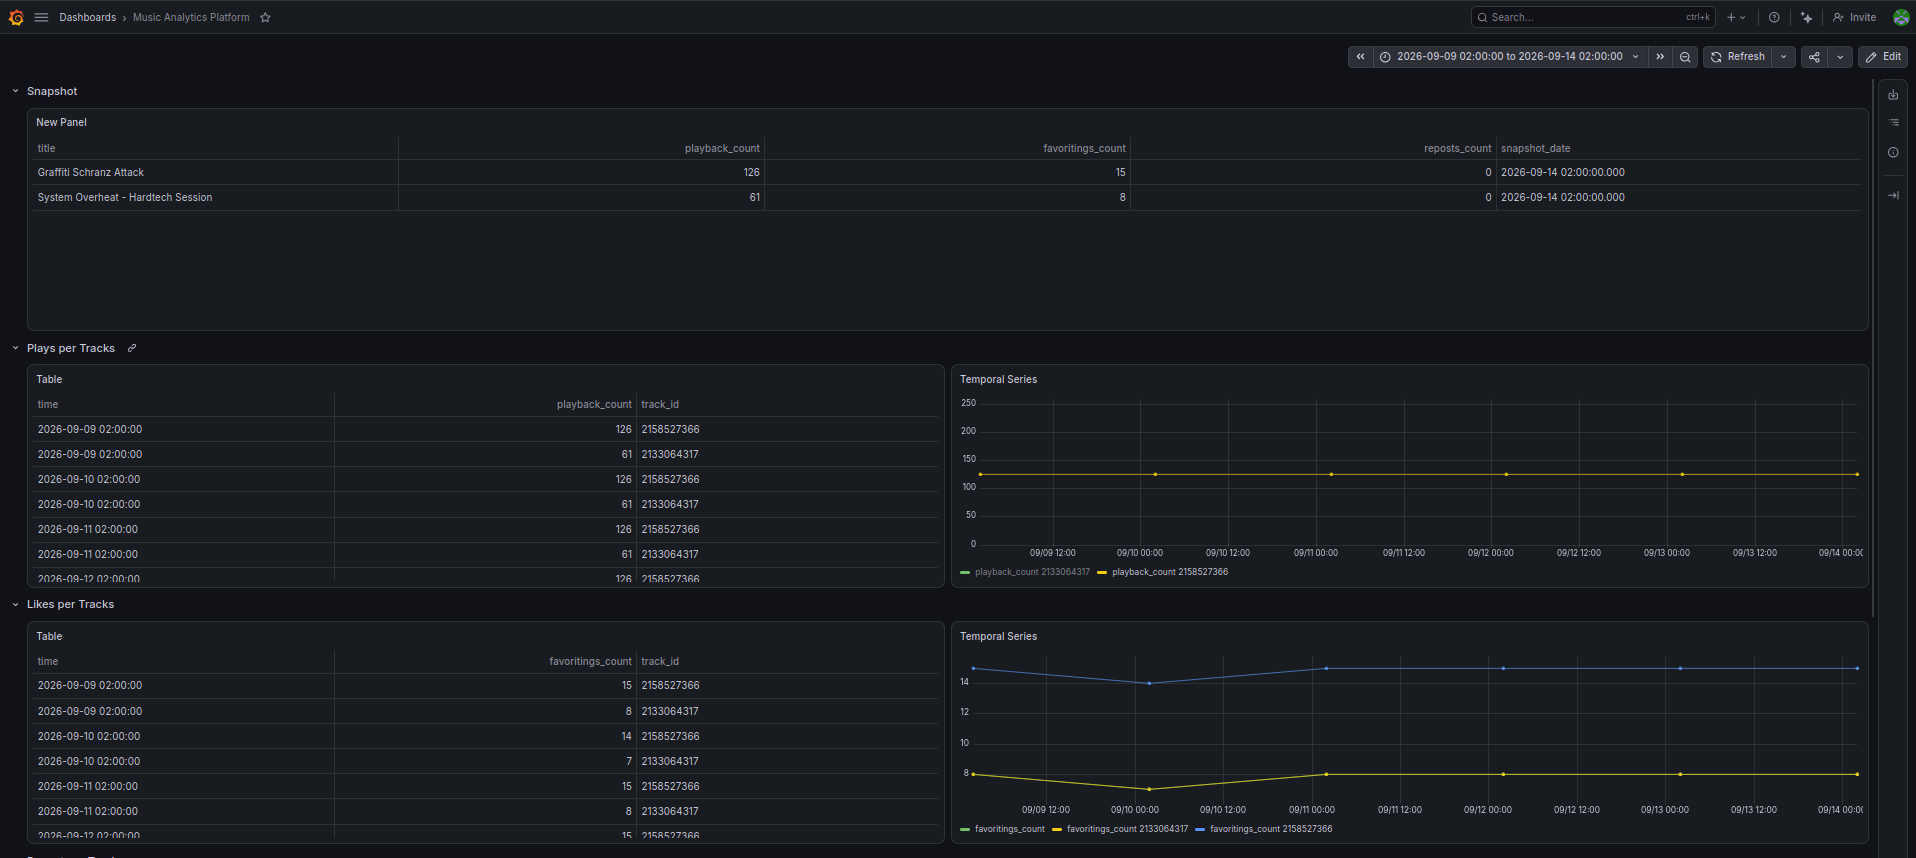
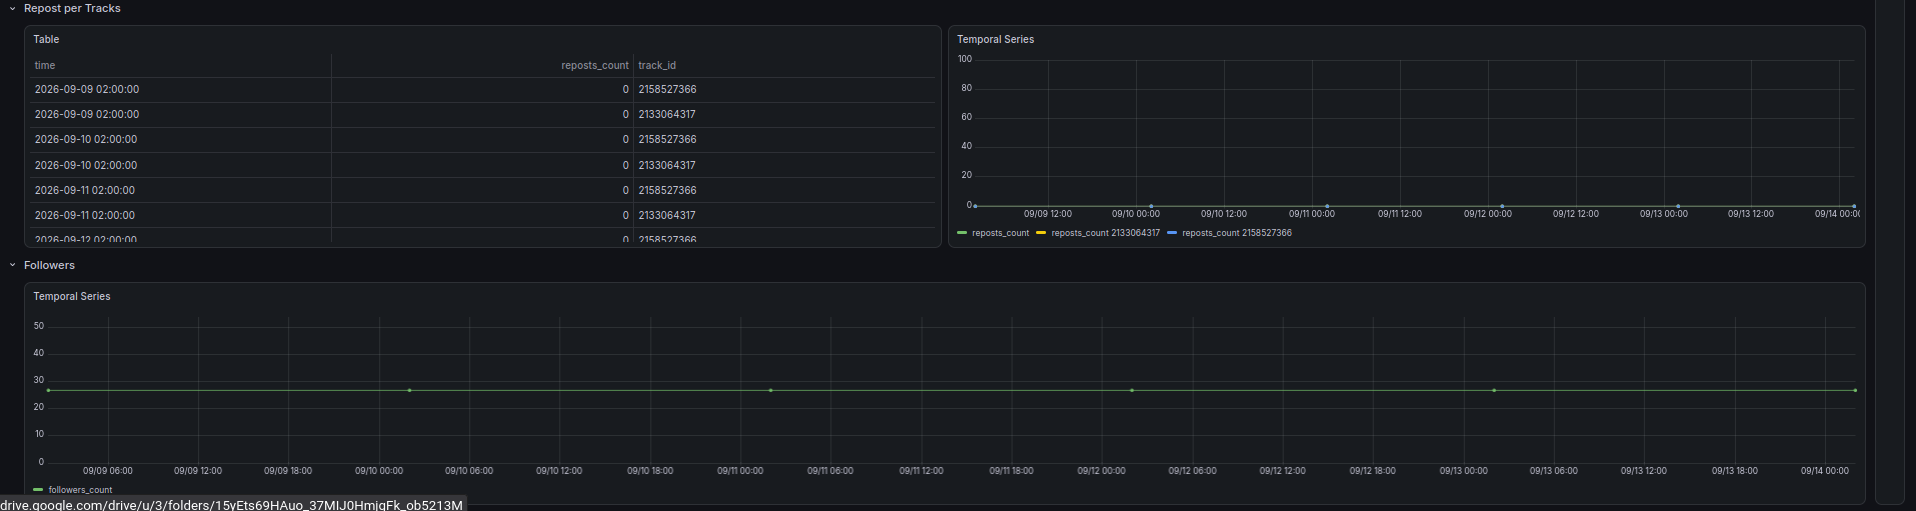
Una vez solucionado todo esto, el pipeline funcionó de principio a fin sin que tuviera que tocar nada: EventBridge ejecutó Lambda, Lambda leyó mis estadísticas de SoundCloud, las escribió en RDS y Grafana las recogió. Ese es el resultado que buscaba: un dashboard que se actualiza solo cada día y con datos que realmente miro.
Coste
Dejé el stack funcionando durante 5 días para obtener algunos datos reales y después revisé AWS Cost Explorer, separado por servicio:
| Servicio | Coste (5 días) |
|---|---|
RDS (db.t4g.micro) |
~$0.0000006 |
| Lambda | $0 |
| Secrets Manager | ~$0 |
| S3 / DynamoDB (Terraform backend) | $0 |
| EventBridge / CloudWatch | $0 |
| Total | $0.00 |
No es una exageración: al redondear, el coste es cero. Los costes quedaron cubiertos por el free tier de 12 meses de la nueva cuenta de AWS. Fuera del free tier, los mismos 5 días costarían aproximadamente **$1.92**, suponiendo un precio de RDS de unos $0.016/hora.
Sigue siendo un coste bajo para despliegues temporales, especialmente usando la estrategia de desplegar y destruir bajo demanda descrita en el ADR 0006.
Qué demuestra este proyecto
Más allá del dashboard, las partes que destacaría en una entrevista son precisamente las que explico en este post: políticas IAM con mínimo privilegio, separación de credenciales entre Parameter Store y Secrets Manager, estado remoto de Terraform con locking y, probablemente más importante que todo lo anterior, varios ejemplos reales de decisiones de arquitectura que tuvieron que cambiar cuando se enfrentaron a una cuenta real de AWS en lugar de quedarse solo en la documentación.
Nada de esto es ingeniería especialmente complicada por separado. Lo que sí me obligó a practicar fue leer un mensaje de error, plantear una hipótesis sobre lo que podía estar fallando y comprobarla. El proceso es el mismo tanto si el problema es un argumento de Terraform que falta como si es una comilla mal puesta en bash.
El código completo, incluyendo los ADRs con las decisiones de arquitectura que se mencionan aquí y algunas más, está disponible en GitHub.